Vulnerabilidades críticas no PHP: uma investigação sobre código aberto, SaaS e aplicações de IA
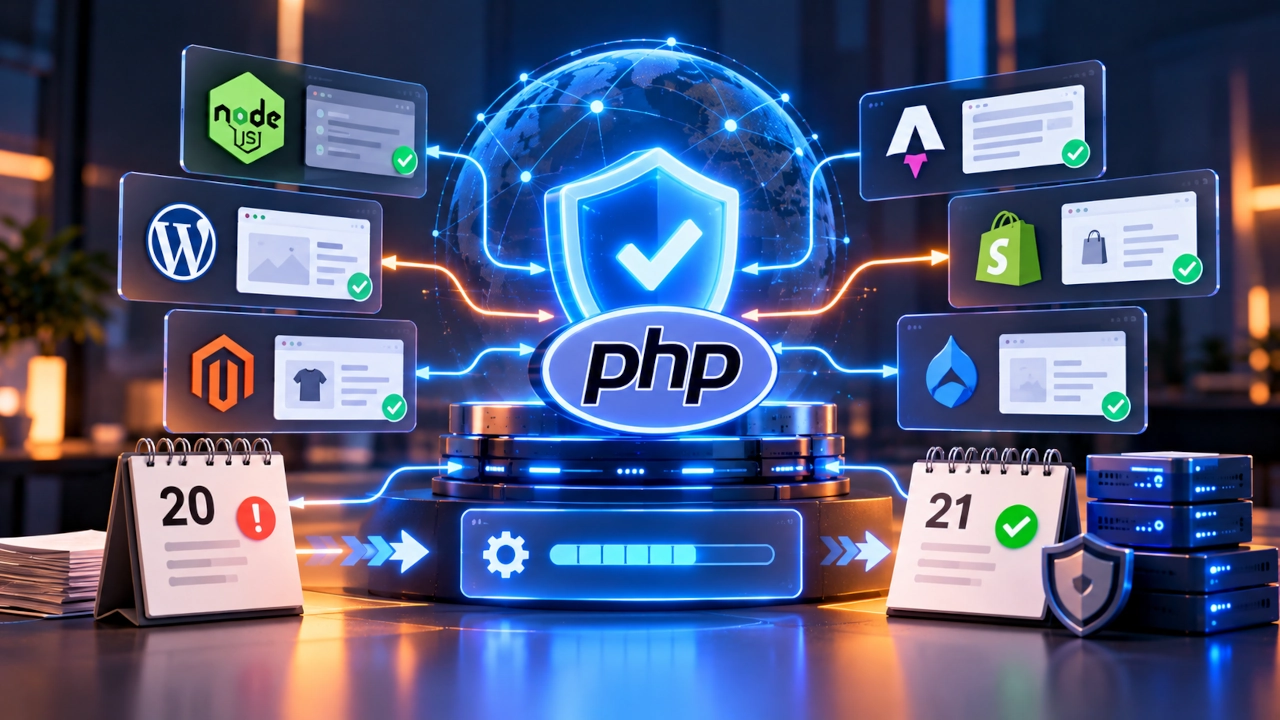
Nos últimos dias, duas vulnerabilidades críticas no PHP movimentaram o mercado de tecnologia. Os alertas foram graves, as classificações chamaram atenção e rapidamente começaram as discussões sobre a segurança da linguagem, do WordPress e das aplicações que dependem dessa infraestrutura. Mas, enquanto acompanhava os comunicados, uma coisa me chamou mais atenção do que as vulnerabilidades em si: o PHP anunciou a necessidade de uma atualização crítica em 20 de outubro e disponibilizou as versões corrigidas no dia seguinte.
Foi aí que resolvi investigar um pouco mais. Porque existe uma diferença enorme entre uma tecnologia apresentar vulnerabilidades e uma tecnologia possuir estrutura para responder a elas. Uma coisa é encontrar um problema. Outra é reconhecê-lo, compreender seu impacto, desenvolver uma correção, coordenar sua distribuição e garantir que essa correção chegue aos sistemas que realmente estão expostos. E essa segunda parte, embora receba muito menos atenção, talvez revele mais sobre a maturidade de um ecossistema do que a quantidade de vulnerabilidades que aparece em seus comunicados.
Comecei pelo PHP, mas não fiquei nele. Fui olhar o que estava acontecendo em Node.js, Astro, Lovable, Shopify, Adobe Commerce, Magento e Drupal. Queria entender quais problemas haviam sido documentados, quais correções estavam disponíveis, quais incidentes ainda exigiam investigação e o que essas situações revelavam sobre código aberto, plataformas SaaS e desenvolvimento assistido por inteligência artificial.
O resultado foi uma reflexão que considero necessária. Porque o mercado costuma discutir segurança como se ela fosse uma característica definitiva da tecnologia escolhida. Contrata-se uma plataforma conhecida, adota-se um framework moderno, escolhe-se um serviço gerenciado ou utiliza-se inteligência artificial para construir uma aplicação e, de alguma maneira, parte da responsabilidade parece desaparecer.
Mas responsabilidade não desaparece quando a tecnologia muda. Ela apenas muda de lugar.
O PHP apresentou falhas críticas e a resposta pública foi rápida
Em 20 de outubro de 2026, a equipe de segurança do PHP publicou um aviso antecipado sobre duas vulnerabilidades críticas, identificadas como CVE-2026-109618 e CVE-2026-109619, ambas com classificação CVSS 9,2 na versão 4.0 do sistema de avaliação.
Os problemas estavam relacionados ao tratamento interno de memória e ao gerenciamento de estados utilizados durante o processamento de requisições. Em determinadas condições, poderiam permitir execução remota de código sem autenticação.
A gravidade não pode ser minimizada. Estamos falando de vulnerabilidades em uma camada de infraestrutura que sustenta WordPress, WooCommerce e inúmeras outras aplicações. Em pelo menos um cenário de exploração demonstrado, relacionado ao Apache com mod_php, uma requisição maliciosa poderia desencadear o problema antes mesmo da execução do código da aplicação.
Isso muda completamente a natureza da resposta. Não estamos falando de uma falha que necessariamente possa ser corrigida atualizando um plugin, alterando uma página ou instalando uma ferramenta de segurança dentro do WordPress. Estamos falando do ambiente de execução que permite ao software funcionar.
No dia 21 de outubro, o projeto publicou as versões PHP 8.2.35, 8.3.36, 8.4.27 e 8.5.12, contendo as correções. No comunicado oficial de segurança, a equipe recomendou a atualização imediata e esclareceu que medidas temporárias de mitigação não substituíam os patches.
Esse intervalo de aproximadamente um dia entre o aviso público e a disponibilização das versões corrigidas merece atenção. Mas não significa que as vulnerabilidades tenham sido descobertas e solucionadas em apenas 24 horas. O comunicado foi uma etapa pública de um processo de segurança que já estava em andamento.
E essa distinção é fundamental.
O PHP não se corrigiu por mágica. Existe uma comunidade, uma equipe de segurança, pesquisadores, mantenedores, distribuidores de software, fornecedores de hospedagem e profissionais de infraestrutura envolvidos na construção e na aplicação das atualizações.
Quando uma correção desse porte é publicada, não estamos vendo apenas uma alteração no código. Estamos vendo uma cadeia técnica sendo mobilizada para proteger aplicações que dependem daquela infraestrutura.
Isso não transforma o PHP em uma tecnologia invulnerável, nem elimina a necessidade de avaliar criticamente como suas vulnerabilidades são identificadas e tratadas. Mas demonstra a existência de uma estrutura organizada de resposta.
E talvez esse seja um dos aspectos mais subestimados dos grandes ecossistemas de software.
Enquanto o mercado discutia PHP, o Node.js também recebia correções
Uma das primeiras coisas que encontrei na investigação foi uma coincidência interessante. No mesmo dia 21 de outubro, o projeto Node.js disponibilizou atualizações de segurança para suas linhas 22, 24 e 26.
Os comunicados descreviam problemas envolvendo, entre outros componentes, resolução de nomes DNS, validação de certificados TLS e dependências do ambiente de execução. A classificação máxima das falhas corrigidas nesse lançamento era alta.
Não estou afirmando que esses problemas possuem a mesma gravidade das vulnerabilidades do PHP. Não possuem necessariamente as mesmas condições de exploração, os mesmos impactos ou a mesma superfície de ataque.
Mas a coincidência mostra uma coisa importante.
Node.js é uma tecnologia fundamental para inúmeras aplicações modernas. PHP é uma tecnologia consolidada que continua sustentando uma parcela importante da web. Ambos dependem de componentes, bibliotecas, protocolos, processos de atualização e equipes capazes de responder a problemas de segurança.
O mercado gosta de associar novidade à superioridade técnica, como se uma linguagem mais recente estivesse naturalmente protegida contra riscos que afetam tecnologias mais antigas. Mas vulnerabilidades não obedecem à idade da ferramenta.
Uma tecnologia pode possuir décadas de desenvolvimento e mecanismos maduros de resposta. Outra pode ter uma arquitetura mais recente e apresentar riscos em bibliotecas ou componentes fundamentais. Nenhum desses fatos, isoladamente, define qual delas é mais adequada ou mais segura para uma operação específica.
A escolha tecnológica precisa considerar contexto, arquitetura, manutenção e responsabilidade.
Modernidade não é uma certificação de segurança.
Astro: uma dependência pode mudar a segurança de toda uma funcionalidade
O Astro é um framework que considero interessante para determinados tipos de projeto. Pode fazer muito sentido em sites de conteúdo, arquiteturas específicas de frontend e aplicações nas quais sua abordagem de renderização representa uma vantagem real.
Inclusive, na ZionLab trabalhamos com Astro quando essa escolha é coerente com os requisitos do projeto. Arquitetura deveria ser consequência do problema, não preferência ideológica por uma ferramenta.
Mas, em 27 de agosto de 2026, o próprio projeto divulgou uma vulnerabilidade crítica envolvendo a otimização de imagens AVIF. O problema estava relacionado à biblioteca libheif, utilizada pelo serviço de imagens baseado em Sharp, e poderia permitir execução remota de código quando um atacante conseguisse fazer o sistema processar uma imagem AVIF maliciosa.
O aviso recebeu classificação CVSS 9,8, e a correção foi disponibilizada na versão Astro 7.2.8.
Esse detalhe importa. Não se trata de afirmar que qualquer site construído com Astro poderia ser comprometido automaticamente. A exploração dependia de condições específicas, especialmente da possibilidade de processar uma imagem não confiável.
O que torna o episódio interessante é justamente sua origem.
Uma funcionalidade aparentemente comum, como otimizar imagens, depende de bibliotecas que possuem seu próprio código, seus próprios mantenedores e seus próprios riscos. O framework pode ter uma arquitetura muito bem desenhada, mas continua incorporando componentes que precisam ser acompanhados e atualizados.
Isso vale para Astro, WordPress, Next.js e praticamente qualquer sistema moderno.
Uma aplicação não se torna independente de vulnerabilidades porque utiliza uma arquitetura diferente. Ela passa a possuir outras dependências, outros caminhos de execução e outras responsabilidades de manutenção.
Trocar tecnologia pode reduzir determinados riscos e introduzir outros. O que define a qualidade da decisão é compreender essas diferenças.
Uma arquitetura moderna continua precisando de engenharia.
Lovable: quando a correção leva duas horas, mas o reconhecimento demora semanas
Talvez um dos casos que mais tenham chamado minha atenção tenha sido o da Lovable.
A plataforma representa uma mudança importante na maneira como aplicações podem ser construídas. Pessoas conseguem transformar instruções em interfaces, funcionalidades e sistemas completos com uma velocidade impressionante. Isso amplia o acesso ao desenvolvimento e cria possibilidades reais de produtividade.
Mas existe uma diferença entre acelerar a produção de software e amadurecer os processos que garantem sua segurança.
Em abril de 2026, a Lovable reconheceu uma falha que permitia a outros usuários autenticados acessar o código-fonte e o histórico de conversas de projetos públicos, desde que possuíssem o link correspondente. Segundo o relatório publicado pela própria empresa, projetos privados e o Lovable Cloud não foram afetados.
O problema surgiu de uma regressão de backend que reintroduziu um comportamento de acesso anteriormente removido.
Mas a parte mais interessante da investigação está na cronologia.
A própria empresa informou que pesquisadores haviam enviado relatórios válidos por seu programa de divulgação responsável. O primeiro foi registrado em 22 de fevereiro de 2026. A correção ocorreu em 20 de abril, aproximadamente 57 dias depois.
Após a divulgação pública, a empresa informou ter implantado a correção em cerca de duas horas.
Perceba a diferença.
A capacidade de corrigir rapidamente existia. O problema também estava no processo de reconhecimento e encaminhamento das informações recebidas.
Segundo a retrospectiva oficial do incidente, os relatórios foram encerrados durante a triagem, sem chegar adequadamente à equipe interna de segurança, porque a documentação utilizada ainda descrevia aquele comportamento como esperado.
A empresa reconheceu a falha de processo, corrigiu o problema e anunciou mudanças em seus procedimentos de triagem e comunicação.
Esse caso revela algo que considero fundamental: segurança não depende apenas de bons desenvolvedores. Depende também da capacidade organizacional de reconhecer quando existe um problema que precisa ser tratado.
Uma vulnerabilidade pode ser tecnicamente simples de corrigir e, ainda assim, permanecer durante semanas se a organização não conseguir identificá-la como prioridade.
E isso não é uma crítica exclusiva à Lovable ou às plataformas de inteligência artificial. É um problema de governança que pode acontecer em qualquer fornecedor, independentemente da linguagem ou do modelo de negócio.
O episódio, entretanto, ganha importância em um mercado que vem acelerando a criação de aplicações.
Gerar uma interface funcional não significa que os controles de acesso estejam adequados. Construir um banco de dados não significa que suas permissões foram revisadas. Publicar uma aplicação não significa que alguém tenha validado todos os caminhos pelos quais informações sensíveis podem ser acessadas.
A inteligência artificial pode acelerar a implementação. Mas alguém continua precisando compreender o que foi implementado.
E, principalmente, alguém precisa assumir a responsabilidade por aquilo que entrou em produção.
Shopify: quando o checkout não é comprometido, mas a jornada de compra pode ser
Em outubro de 2026, incidentes envolvendo aplicativos utilizados em lojas Shopify trouxeram outra dimensão para essa discussão.
Um dos casos documentados envolveu o Swym Wishlist Plus, aplicativo integrado a vitrines de comércio eletrônico. Segundo o comunicado oficial da Swym, em 14 de outubro um agente não autorizado alterou a configuração do aplicativo, fazendo com que um script malicioso fosse carregado em determinadas páginas de um subconjunto de lojas.
O script poderia redirecionar consumidores que tentassem finalizar a compra para uma página externa que imitava um checkout legítimo e buscava coletar dados de cartão.
É importante fazer uma distinção que considero indispensável: o comunicado não demonstra uma invasão do núcleo do checkout da Shopify. O incidente envolveu um aplicativo de terceiros e código carregado na vitrine.
Mas isso não torna o problema irrelevante. Para o consumidor, o risco podia aparecer justamente no momento de pagar.
A Swym informou que a alteração não autorizada ocorreu a partir de aproximadamente 10h06 UTC e que todas as medidas de contenção daquele episódio estavam implantadas até 16h32. Portanto, o intervalo entre o início identificado e a conclusão da contenção foi de cerca de seis horas e meia.
A empresa também informou ter revertido a configuração indevida, protegido o canal de acesso envolvido e removido o script das vitrines afetadas.
Mas o assunto não terminou simplesmente naquele primeiro episódio.
Em 20 de outubro, a Swym publicou uma nova atualização sobre o incidente, relatando atividades não autorizadas adicionais e anunciando a suspensão preventiva do aplicativo para todos os comerciantes enquanto continuava investigando e reforçando sua segurança.
Isso não significa que os ataques tenham permanecido ativos durante todo esse período. Tampouco permite afirmar que dados de todos os consumidores ou comerciantes tenham sido comprometidos. Segundo a empresa, não havia evidência de comprometimento de dados armazenados pelo aplicativo, embora consumidores que tivessem inserido informações nas páginas externas pudessem ter sido afetados.
O caso mostra uma fragilidade que não está necessariamente no núcleo de uma plataforma, mas nas relações entre diferentes componentes de uma operação digital.
Uma loja pode utilizar um serviço gerenciado, ter seu checkout central protegido e continuar dependendo de aplicativos, scripts, integrações, credenciais e fornecedores externos.
E essa dependência não é exclusiva de SaaS.
Uma operação WordPress também pode enfrentar problemas por extensões comprometidas, credenciais indevidas ou integrações mal protegidas. A diferença está na maneira como as responsabilidades são distribuídas.
Em um SaaS, o fornecedor pode aplicar medidas centralizadas e interromper rapidamente uma integração para muitos clientes. Essa é uma vantagem operacional real. Ao mesmo tempo, o lojista depende de decisões externas e pode ver uma funcionalidade comercial suspensa sem controlar diretamente o processo de correção.
Em uma operação autogerenciada, a empresa pode possuir maior liberdade de intervenção, mas precisa ter capacidade técnica para exercê-la.
Autonomia sem manutenção não é segurança. Centralização sem governança de dependências também não.
O problema raramente termina no nome da plataforma.
Magento e Drupal: o patch pode existir enquanto a operação continua exposta
Outro aspecto importante da investigação apareceu nos comunicados de Adobe Commerce, Magento Open Source e Drupal.
Em 7 de setembro de 2026, a Adobe publicou um boletim de segurança sobre a CVE-2026-75650, uma vulnerabilidade crítica capaz de permitir execução arbitrária de código em versões afetadas de Adobe Commerce e Magento Open Source.
A classificação foi CVSS 10,0, e a própria Adobe informou ter conhecimento de exploração ativa. O fornecedor disponibilizou um hotfix e orientou a atualização dos ambientes afetados.
Já em 14 de outubro, a equipe de segurança do Drupal divulgou a CVE-2026-108097, relacionada ao módulo Field UI do núcleo. O problema poderia permitir execução remota de código em determinadas combinações com módulos contribuídos ou código personalizado. O comunicado esclareceu que a vulnerabilidade não era diretamente explorável apenas com o núcleo, mas que existiam caminhos relevantes de exploração, incluindo pelo menos um que não exigia autenticação.
O Drupal publicou versões corrigidas e também indicou a desinstalação do módulo Field UI como medida de mitigação enquanto os ambientes fossem atualizados.
Esses casos ajudam a separar duas situações que frequentemente são tratadas como se fossem a mesma coisa.
O fornecedor disponibilizou a correção. Mas a empresa aplicou?
Existe uma distância entre o momento em que um patch é publicado e aquele em que a operação efetivamente deixa de executar uma versão vulnerável.
Alguns ambientes recebem atualizações rapidamente. Outros dependem de homologação, compatibilidade com extensões, fornecedores externos, janelas de manutenção ou profissionais que acompanhem os boletins.
E outros simplesmente continuam desatualizados.
Isso vale para Magento, Drupal, WordPress, PHP, Node.js e qualquer aplicação que dependa de componentes mantidos por terceiros.
A correção pode estar disponível no repositório oficial e, ainda assim, existirem instalações utilizando versões antigas. Sem dados específicos sobre instalações atualizadas, não é possível afirmar quantas permanecem expostas.
Esse é o ponto: patch disponível não significa patch aplicado.
O problema de comparar segurança contando vulnerabilidades
Depois de analisar esses episódios, comecei a perceber como as discussões sobre segurança frequentemente utilizam a métrica errada.
O mercado gosta de contar vulnerabilidades. Uma tecnologia aparece com muitas CVEs e passa a ser tratada como insegura. Outra possui menos divulgações e começa a parecer superior.
Mas a quantidade de vulnerabilidades conhecidas não representa, sozinha, uma medida suficiente da segurança de uma plataforma.
Um software amplamente utilizado pode receber mais atenção de pesquisadores. Um projeto com código acessível permite auditorias independentes. Uma aplicação proprietária pode contar com equipes internas altamente especializadas. Diferentes fornecedores também possuem políticas distintas de divulgação, classificação e agrupamento de falhas.
Nada disso significa que vulnerabilidades sejam positivas ou que números elevados devam ser ignorados.
Significa apenas que uma comparação séria precisa considerar contexto.
A gravidade importa. A possibilidade real de exploração importa. A existência de ataques conhecidos importa. A exposição dos ambientes importa. A velocidade de resposta importa. E a capacidade de aplicar a correção também importa.
Mais importante ainda: o tempo de resposta não é um número único.
Existe o momento da descoberta, o reconhecimento do problema, a disponibilização de uma correção, a contenção de um ataque e a atualização efetiva dos sistemas afetados.
No PHP, as versões corrigidas foram publicadas aproximadamente um dia depois do aviso público. Isso não informa quanto durou todo o trabalho anterior à divulgação.
No Node.js, as versões corrigidas estavam disponíveis no dia 21 de outubro, junto ao comunicado de lançamento. Isso também não equivale ao tempo total desde a descoberta privada das falhas.
Na Lovable, temos uma cronologia mais extensa porque a própria empresa informou a data do primeiro relato válido e reconheceu uma deficiência no processo de triagem.
Na Swym, temos horários de atividade e contenção de um incidente específico, além de uma investigação posterior. Mas contenção operacional não é a mesma coisa que correção de uma vulnerabilidade de código.
Misturar esses intervalos e montar um ranking de velocidade entre empresas seria tecnicamente inadequado.
O que podemos fazer é observar como cada organização reconhece riscos, comunica o problema, disponibiliza proteção e assume responsabilidade pelo que aconteceu.
Segurança não é uma corrida entre comunicados. É um processo contínuo.
Código aberto não significa segurança automática, código fechado também não
Existe uma discussão antiga sobre código aberto que sempre reaparece quando uma vulnerabilidade ganha repercussão.
De um lado, a ideia de que software aberto seria menos seguro porque qualquer pessoa pode estudar seu funcionamento. Do outro, a defesa de que ele seria automaticamente superior porque qualquer pessoa pode identificar e corrigir falhas.
Nenhuma dessas interpretações é suficiente.
Código aberto permite revisão independente, colaboração distribuída, participação de pesquisadores e possibilidade de adaptação. Quando existe uma comunidade madura, essas características podem contribuir para respostas coordenadas e ampliar as opções de quem mantém a infraestrutura.
Mas disponibilidade do código não significa que todas as suas partes foram auditadas. Tampouco garante que a comunidade terá recursos suficientes para corrigir qualquer problema rapidamente.
O modelo proprietário também possui vantagens. Um fornecedor pode concentrar conhecimento especializado, monitorar a infraestrutura e distribuir correções de maneira centralizada, muitas vezes sem exigir que cada cliente execute uma atualização.
Por outro lado, clientes podem ter menos visibilidade sobre determinados componentes e menos liberdade para intervir diretamente em incidentes.
Os dois modelos podem ser bem administrados. Os dois também podem falhar.
Por isso, considero pouco produtiva a discussão que tenta transformar open source e SaaS em adversários absolutos.
A pergunta mais interessante é outra: qual modelo distribui as responsabilidades de maneira mais adequada para aquele negócio, considerando sua equipe, seus recursos, seus riscos e sua necessidade de controle?
Uma empresa pode escolher uma operação própria e mantê-la muito bem. Pode escolher SaaS e obter uma excelente estrutura de segurança. Pode também operar qualquer um desses modelos de maneira negligente.
Segurança não vem automaticamente da licença de software.
Ela depende do conjunto.
Aplicações com IA e a nova dívida de segurança
A chegada das ferramentas de desenvolvimento assistido por inteligência artificial torna essa discussão ainda mais importante.
Hoje, uma empresa pode gerar interfaces, autenticação, estruturas de banco de dados, integrações e funcionalidades em um intervalo de tempo muito menor do que o necessário em processos tradicionais.
Isso representa uma transformação relevante na produtividade do desenvolvimento.
Mas existe uma pergunta que nem sempre acompanha essa velocidade: quem está assumindo a responsabilidade pelo sistema que acabou de ser criado?
A IA pode gerar uma área restrita, mas alguém precisa compreender como os controles de acesso funcionam. Pode conectar um banco de dados, mas alguém precisa revisar suas permissões. Pode construir um fluxo comercial, mas alguém precisa avaliar as integrações, os segredos utilizados, o tratamento de dados e as consequências de uma falha.
A ferramenta pode auxiliar na implementação e até na identificação de problemas. O que ela não faz, por si só, é substituir todos os processos organizacionais necessários para manter uma aplicação em produção.
O risco é que o mercado passe a confundir facilidade de criação com ausência de complexidade.
Uma aplicação pode parecer simples para quem a utiliza e continuar extremamente complexa por trás da interface. Pode depender de serviços externos, bibliotecas, infraestrutura, políticas de acesso e mecanismos de atualização que seu próprio responsável não conhece.
Essa é uma dívida de segurança que pode surgir antes mesmo de a empresa perceber que está assumindo uma dívida.
Não porque inteligência artificial seja inadequada para desenvolver software, mas porque velocidade sem revisão proporcional pode ampliar o volume de sistemas que precisam ser mantidos.
O desenvolvimento ficou mais acessível. A responsabilidade pela operação não ficou opcional.
A segurança digital é uma responsabilidade arquitetural
Na ZionLab, trabalhamos com uma visão bastante clara sobre tecnologia: uma operação digital precisa ser compreendida como um sistema.
Isso significa que WordPress, WooCommerce, PHP, frameworks, plataformas SaaS, APIs, dados, integrações, infraestrutura e inteligência artificial não deveriam ser analisados como ferramentas desconectadas.
Cada componente possui responsabilidades e estabelece relações com outros componentes.
Uma falha pode aparecer em uma biblioteca. Uma integração pode possuir permissões excessivas. Um serviço externo pode ser comprometido. Uma atualização pode não chegar ao ambiente de produção. Um aplicativo pode alterar uma etapa comercial importante sem que a empresa perceba imediatamente.
A segurança depende de conhecer essas relações.
Não basta contratar uma plataforma conhecida e presumir que toda a operação está protegida. Não basta utilizar código aberto e acreditar que a comunidade fará todo o trabalho. Não basta atualizar plugins e ignorar o ambiente de execução. Não basta desenvolver uma aplicação com IA e considerar o projeto encerrado no momento da publicação.
A empresa precisa saber quais componentes utiliza, quem os mantém, quais versões estão em produção, como recebe alertas, quem possui acesso, quais integrações podem modificar informações sensíveis e quem tem autoridade para agir diante de um incidente.
Isso não significa que toda organização precise manter uma grande equipe interna de segurança. Significa que a responsabilidade precisa estar claramente definida, seja internamente, por fornecedores ou por uma combinação de competências.
O risco não desaparece quando uma empresa terceiriza uma parte da infraestrutura.
Ele precisa continuar sendo administrado.
Na minha visão
Na minha visão, as vulnerabilidades críticas do PHP revelaram uma questão muito maior do que a segurança de uma linguagem de programação. Revelaram como o mercado ainda possui dificuldade para distinguir vulnerabilidade, exposição, correção e responsabilidade operacional.
O PHP enfrentou falhas graves e disponibilizou atualizações rapidamente após o aviso público. Isso demonstra capacidade de resposta, mas não torna a tecnologia invulnerável nem garante que todos os servidores tenham sido corrigidos.
O Node.js também precisou publicar atualizações. O Astro corrigiu uma vulnerabilidade crítica relacionada ao processamento de imagens. A Lovable reconheceu uma falha de triagem que retardou o tratamento de um problema de acesso a informações. A Swym precisou conter atividades maliciosas que afetavam vitrines Shopify. Adobe Commerce, Magento e Drupal também divulgaram correções para vulnerabilidades graves.
São problemas diferentes, com impactos e circunstâncias distintas. Não seria correto utilizá-los para declarar que uma tecnologia é superior às outras.
Mas existe algo que todos ajudam a demonstrar.
Uma aplicação não é segura apenas porque sua linguagem é moderna. Um SaaS não elimina automaticamente riscos de integrações. Um projeto open source não fica protegido apenas porque seu código pode ser auditado. E uma aplicação criada com inteligência artificial não dispensa revisão técnica porque foi produzida rapidamente.
A grande vantagem de um ecossistema maduro não está na promessa de nunca enfrentar vulnerabilidades. Está em desenvolver processos consistentes para reconhecê-las e responder adequadamente quando elas aparecem.
E essa capacidade não pertence exclusivamente ao código aberto. Pode existir em projetos comunitários, fornecedores proprietários, ambientes gerenciados e operações próprias.
A diferença é que cada modelo distribui controle, visibilidade e responsabilidade de maneira distinta.
Por isso, antes de perguntar se WordPress, PHP, Shopify, Astro ou qualquer outra tecnologia é segura, considero mais importante perguntar quem está mantendo aquela operação, quem acompanha suas dependências, quem aplica suas correções e o que acontece quando algo sai do esperado.
Porque uma vulnerabilidade corrigida no código pode continuar presente na infraestrutura. Uma integração aparentemente secundária pode comprometer uma etapa crítica do negócio. E uma empresa pode possuir ferramentas modernas de proteção sem ter clareza sobre quem responde por um incidente.
Segurança não é uma propriedade permanente de uma linguagem, framework ou plataforma. É uma capacidade contínua de engenharia, manutenção e governança.
O PHP não se tornou invulnerável porque publicou correções rapidamente. Assim como nenhuma outra tecnologia se torna automaticamente segura porque oferece simplicidade, modernidade, infraestrutura gerenciada ou geração de código por inteligência artificial.
Depois dessa investigação, acredito que o maior erro das empresas não seja necessariamente escolher uma tecnologia inadequada.
É acreditar que a escolha da tecnologia encerra a responsabilidade sobre ela.
E essa é uma vulnerabilidade organizacional que nenhum patch, sozinho, consegue corrigir.
Biblioteca para continuar a leitura
Para quem quiser aprofundar a discussão sobre arquitetura, autonomia tecnológica e responsabilidade operacional, deixo alguns conteúdos relacionados:
Arquitetura própria: a diferença entre estar online e ser compreendido pela nova internet
WooCommerce é melhor que SaaS? A escolha que define o limite do seu e-commerce
Canal próprio vs canal alugado: a conta que muitas empresas só fazem tarde demais
O que é um ativo digital próprio: por que sua empresa precisa construir um
Investigação baseada em comunicados oficiais e registros públicos de segurança consultados em 22 de outubro de 2026. Os episódios analisados possuem causas, condições de exploração e impactos diferentes. Não constituem uma classificação comparativa de segurança entre plataformas.
Canal ZionLab no WhatsApp
Entre no canal da ZionLab no WhatsApp e receba conteúdos estratégicos, novas publcações e atualizações para evoluir sua operação no digital.
Aviso de conteúdo
É proibida a reprodução, total ou parcial, do conteúdo desta página em qualquer meio, seja eletrônico, digital ou impresso, sem a devida autorização por escrito dos responsáveis.
Veja Também

WooCommerce e comércio agêntico: quando a loja virtual passa a vender para agentes de IA

Vulnerabilidades críticas no PHP: uma investigação sobre código aberto, SaaS e aplicações de IA
Tema pronto, page builder ou desenvolvimento sob medida: o que muda na arquitetura do site
Core Web Vitals: o que LCP, INP e CLS realmente dizem sobre a experiência do seu site
Mais Lidas


Categorias
- E-commerce (38)
- Inteligência Artificial (18)
- Legado Digital (7)
- Marketing Digital (18)
- Midia (16)
- Negócios (44)
- SEO (32)
- WooCommerce (59)
- WordPress (44)